
 中文

MeGusta deepin
2026-10-16 11:59 deepin It has been deleted!
 deepin
 deepin
Agent辅助Debug的效率真的高。

 deepin
能这么解决问题的,应该是内核方面的专家了,666啊!
为龙芯用户扫除了一大隐患。在前几次编译有道云笔记、清风输入法时,就出现电脑死机的情况,在编译、测试时,电脑风扇是狂转的,应该是大负载的时候了,当时以为电脑配置不够,现在看来应该是这个情况触发的。提高系统的稳定性了。
再次感谢老铁为龙平台解决了大问题🙏。
 deepin
看不懂,不明白,觉厉害!

 deepin
这个Wentao Guan看来就是deepin的内核专家了
 deepin
不明觉厉 👍
deepin 这个支持

有AI辅助都要这么长时间,可想而知没有AI的时候得有多困难

 deepin
这个Wentao Guan看来就是deepin的内核专家了
信创内核仙人发力了
关老师我们是你的粉丝口牙!
 deepin
祝贺!期待龙芯生态快速发展
Popular Ranking
ChangePopular Events
More


 Unable to install HP Laserject Pro M15a Printer
deepin 修复内核探针引发的一处缺陷,补丁已合入 Linux 主线!
想象一下这样的场景:系统安装正进行到一半,机器毫无征兆地卡死了,而查串口日志,只有几条零散的异常,内核问题的麻烦就在这里。出错的那一瞬间稍纵即逝,留下来的线索还自相矛盾,真正的根源藏在毫不起眼的一小段执行路径里,排查起来像大海捞针。
deepin 文件管理器提供文件索引功能,索引使用的内核模块通过 VFS 的 kretprobe hook 方法来对文件系统函数进行插桩,在文件访问过程中采集索引所需的信息。近日,大量文件操作叠加内核探针后,LoongArch 平台的一处底层缺陷被触发,系统在安装或解压大镜像时出现卡死情况。
deepin 开发人员围绕这个问题持续排查九天,最终将根因定位到 LoongArch 内核
rethook跳板函数对 percpu 基址恢复错误,并通过针对性实验验证了修复方向。先认识几个概念
this_cpu_*()一类操作访问当前核心的数据,例如调度器与 RCU 状态,也包括定时器、FPU 状态。LoongArch 内核约定使用$r21(也称$u0)保存当前 CPU 的 percpu 基址。内核态运行期间,这个寄存器应始终指向当前核心的 percpu 区域。这次问题是怎样发生的?
老代码把逻辑拆成了三步。
r21(当前 CPU 的 percpu 基址)压栈保存;rethook_trampoline_handler();r21恢复回寄存器。问题出在第 2 步。这个处理函数里面当完全抢占打开时任务有可能在这期间被调度、迁移到另一个 CPU 上运行。
r21值存到栈上;rethook_trampoline_handler()里的preempt_enable_notrace()调度点发生调度,任务被挪到比如 CPU1 继续跑;r21,写回寄存器。现在 CPU1 上的任务,
r21变成了 CPU0 的 percpu 基地址。之后所有this_cpu_*()操作,本来想访问 CPU1 自己的数据(调度队列、RCU、定时器、FPU 状态),结果全都跑去读改 CPU0 的 percpu 数据。会引发什么故障?
在大量使用 kretprobe、系统负载高的时候:
scheduling-while-atomic崩溃报错;WARN_ON_ONCE(rq != this_rq()));复现场景是:龙芯 3A6000,对 VFS 文件系统函数挂大量 kretprobe,同时疯狂读写文件,比如安装系统、
unsquashfs解压大镜像,甚至用户安装软件,解压文件时都可以触发。这个 bug 从 Linux 6.3 版本老 kretprobe 时代就存在,换成 rethook 之后这套错误逻辑被直接拷贝了过来。
为什么此前没有其他人遇到?
因为这处缺陷要三个条件同时凑齐才会出现:系统跑在 LoongArch 上,有模块在内核高频调用的函数上挂了探针,内核开的是完全抢占(
preempt=full)。deepin 的文件索引为了判断文件有没有被改动,正好在文件相关被密集调用的函数上做了插桩;这次出问题的系统,为了让界面点起来更跟手,也开着完全抢占。这三个条件缺一项,问题都不会发生,这也是它此前没有出现在其他人那里的原因。
相对于不开抢占,桌面响应会更及时,相对于自愿抢占,完全抢占下桌面响应延迟更低,而代价是在性能测试上会受到一点影响。正是出于这个考虑,服务器和其他桌面系统版本如 UOS 桌面版本都没有把抢占开到完全抢占。
这个问题之前在 deepin 上没有出现,是因为 LoongArch 架构上此前并未预装 deepin-anything-dkms 这个使用 kretprobe 插桩的内核模块安装包
抢占模式有哪几种,差在哪里?
刚才上面反复提到「抢占」,这里先把它的几种情况掰开揉碎说一下 —— 抢占模式可不是一个开关只有开和关的两档,而是几套不同的模式,这些模式在系统吞吐量与响应时间之间实现了不同程度的权衡。
无抢占(
PREEMPT_NONE/preempt=none):内核只在代码主动调用cond_resched()的地方才肯让出 CPU。cond_resched()是内核代码里显式写下的「这里可以让一下」的位置,通常出现在循环、批量处理这类长时间干活的路径上。除了这些点,其他位置一律不被打断:一个任务进了内核态,就会一路把这段活儿干完,别的任务只能等着。这么做吞吐最高,因为切换次数最少;代价是一旦某段内核操作很久都不让出,响应就会被卡住,服务器和科学计算这类看重单位时间处理量的场景适合它。自愿抢占(
PREEMPT_VOLUNTARY/preempt=voluntary):在无抢占的基础上再放宽一档,把might_sleep()这类「这里可能会睡」的位置也算成调度点。内核代码一旦走进可能睡眠的路径,比如等一个锁、等 I/O,调度器就有机会插进来把 CPU 交给别人。它的思路是:一段代码既然本来就可能睡着,那让它在这儿被打断也没什么额外损失。所以它在不改动「不让出就不打断」这条底线的前提下,把响应的短板补掉了一部分。日常使用中它和完全抢占的差别并不显眼。完全抢占(
PREEMPT/preempt=full):不再等代码自己让出,只要内核没有明确把自己「锁住」,任何位置都能立刻被打断。哪怕正在处理系统调用、正在跑驱动代码,只要有更紧急的任务来了,调度器就能切过去。桌面上点一下、拖一下之所以跟手,靠的就是它。代价是内核里随处可见的切换点,吞吐会掉一些,锁的竞争也更复杂。延迟抢占(
PREEMPT_LAZY/preempt=lazy):在完全抢占模型下,内核通过在多个节点检查need_resched/TIF_NEED_RESCHED并触发任务抢占,比如时钟滴答事件(比如HZ=1000就每秒钟触发1000次)等。延迟抢占新增了一个TIF_NEED_RESCHED_LAZY,用于标记需要在某个时间点重新调度,但不必立即执行。PREEMPT_LAZY介于PREEMPT和PREEMPT_VOLUNTARY之间,意图是在不影响实时任务响应时间的前提下,恢复吞吐量导向任务的性能损失,在v7.0内核版本之后只有PREEMPT_LAZY和PREEMPT两种可选。实时抢占(
PREEMPT_RT):在实时抢占下,内核被改造获得几乎硬实时的能力,完全可抢占,中断线程化,锁可抢占且支持优先级继承,追求低延迟和确定性。而这次的缺陷是在完全抢占下发作的。 跳板函数执行时会短暂地关掉抢占,处理完成再打开。在完全抢占下,这个「打开」的瞬间就是一个真正的调度点,任务可能就在这里被换到另一颗 CPU 上;在无抢占和自愿抢占下,这一步只是把计数减回去,调度器不会在那个窗口里介入,任务不会在那儿换 CPU,也就踩不到后面那个恢复旧基址的错误,延迟抢占从代码上看也会触发缺陷,只是尚未实验。
从这个差别也能看出降级到自愿抢占为什么能应急,因为它并不修掉跳板里的那两行,只是让触发路径走不通。
PREEMPT_DYNAMIC:编译时定的事,可以开机再定
以前抢占模式是在编译内核时就定死的,想换一种就得重新编译、重新发布一套内核,发行版要给服务器、桌面、低延迟桌面各准备一套二进制程序,维护成本高。
Linux 5.12 引入的 PREEMPT_DYNAMIC 解开了这个限制:内核编译时仍然声明一个默认模式,但只要启用了这个选项,开机时用启动参数
preempt=就能改掉它,做法是提前在内核里留好一批开关,开机时按参数把它们挨个拨到对应位置。deepin 桌面版把默认值定在完全抢占,为的是让桌面上的一次点击或拖拽尽快得到响应, 编译配置里的
CONFIG_PREEMPT=y和CONFIG_PREEMPT_DYNAMIC=y定了这个默认值,时钟频率HZ=1000让内核每毫秒有一次时钟中断,完全抢占和自愿抢占在日常使用中的差别其实没那么显眼,换来的是更稳的响应。内核启动时会把生效的模式打进日志,形如
Dynamic Preempt: full,选了哪一档,开机看一眼日志就知道。deepin 桌面把默认值定在完全抢占。 编译时声明完全抢占为默认,需要时还能用启动参数调整,这样桌面响应最快,遇到这次这类只在完全抢占下发作的问题,也能临时把参数改成
preempt=voluntary把触发路径堵住,不必等完整的内核更新走完流程。UOS 桌面编译时定成自愿抢占。 理由有两层:自愿抢占和完全抢占在日常使用中的差别本就不明显;放弃这套机制能省掉改写的开销,也让内核结构更简单,代价是抢占模式从此改不动,想换一种只能重新编译一套内核。
deepin 文件索引如何暴露了缺陷
最初,故障出现在 deepin LoongArch 日构建镜像的安装过程中。装系统时,在安装程序使用
unsquashfs解压镜像,设备会突然卡死,由于串口输出有限,初期日志只显示 SLUB、调度器和抢占相关异常,我们无法直接找出根因。排查人员一度怀疑镜像中新加入的
deepin-anything-dkms模块。这个模块与文件索引有关,使用 VFS kretprobe hook 追踪文件操作,因此成为重要线索。后续实验将根因指向 LoongArch 内核的探针返回路径。模块及高强度文件访问让这处内核缺陷更容易显现。为了减少反复制作镜像和刷机的时间,开发人员把复现过程缩小到安装后的
unsquashfs多轮测试,并使用netconsole网络控制台日志替代物理接入串口控制台,AI 协助分析异常、编写诊断补丁和整理验证思路,每个结论仍通过实际设备上的对照实验确认。连续多轮实验逐渐把范围缩到 rethook 跳板函数、抢占与任务迁移的交互,调试补丁也让问题从"安装时偶发卡死"变成可重复验证的内核故障。最终把任务迁移期间的 percpu 基址异常,和调度、RCU 与定时器上的多种症状对应了起来。
任务换了 CPU,寄存器为什么不用还原?
LoongArch 内核已有明确约定:内核态执行时,
$r21保持为当前 CPU 的 percpu 基址;从用户态进入内核时,异常入口会按架构规则加载相应基址。普通内核上下文切换让任务迁移到另一颗 CPU 后,当前 CPU 的寄存器环境也应使用新核心的 percpu 基址。因此,任务迁移后回到跳板出口时,寄存器中的
$r21已对应当前核心。跳板再把栈里保存的旧值写回去,反而会覆盖正确值,修复方向是在rethook跳板中删除保存和恢复$r21的操作。删除恢复操作足以避免覆盖新核心的基址;同时删除保存操作,也能去掉不再需要的栈空间。龙架构 kretprobe 的跳板汇编错误地保存了 percpu 基址寄存器。如果任务在跳板处理期间被调度迁移到别的 CPU,退出时恢复旧 CPU 的基址,会导致后续代码访问错 CPU 的私有数据,引发调度异常、定时器卡死。按内核约定,内核态下该寄存器始终保持正确值,跳板不需要手动保存恢复,删掉这两行汇编就修复了。
验证根因,而不止让故障消失
这次问题的排查经历了多轮假设和反复验证,最开始认为是一个近期引入的问题,检查 CPU 调频和 USB 自动挂起,也尝试二分内核提交和模块影响,还尝试二分内核提交和模块影响,并尝试不同内核版本,最后发现原版内核也能复现后认为这个是一个上游问题。
调试的难点在尽可能快的复现和缩小问题范围,许多方向最终被实验排除,但每轮结果都让复现范围和观测重点更明确,顺着出现问题的点不断添加调试补丁进行验证,最终找到了内核运行时原始的损坏位置就位于 rethook 跳板本身中。
在一次累计 55 分钟的测试中,任务在 CPU 之间反复迁移 4991 次,设备没有再出现死机。此前,团队用多轮
unsquashfs解压测试验证了故障可以稳定复现,也验证了调试改动对现象的影响。这类错误从 Linux 6.3 的旧 kretprobe 实现时期就已存在;切换到 rethook 后,相关的寄存器保存与恢复逻辑延续了下来,它平时不容易显现,遇到高频探针、抢占和任务迁移等条件叠加时,才被暴露出来。
已合入主线
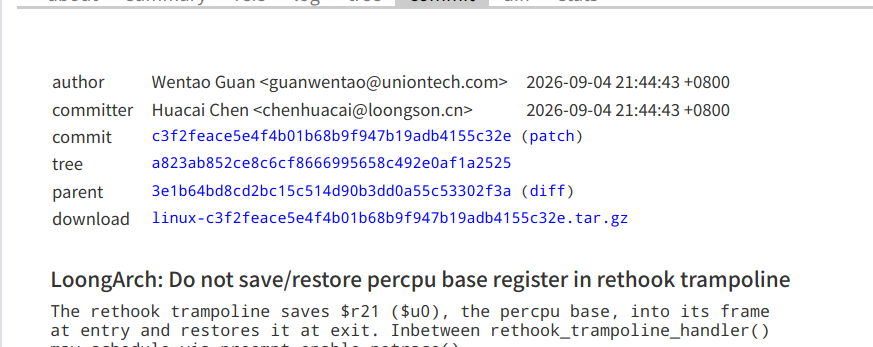
补丁标题:
LoongArch: Do not save/restore percpu base register in rethook trampolinearch/loongarch/kernel/rethook_trampoline.S,增 0 行、删 2 行Fixes: 3f5536860086d ("LoongArch: Add kretprobes support"),影响 v6.3 及以后Cc: stable@vger.kernel.org # v6.3+虽改动只有两行,但定位却花了很长时间!
因为最初的现象指不到这里,安装卡死、串口没有有效输出,或是在报调度异常等各种错误,顺着这些线索往回不断添加了几十个调试补丁进行定位排查,才一步步走到跳板函数。
这个过程里花时间最多的部分,是让问题变得可复现、可观测、可验证,写修复反而是最后一步。
用户会遇到这个问题吗?
这项修复在用户开始反馈之前就已经进入了 Linux 主线,依赖的更新先一步推到了外网,修好的内核当时还没走完测试、没到用户手上,中间这段时间差里,用户仍可能遇到。一个临时的办法是在启动参数里加上
preempt=none或preempt=voluntary,把那个会触发调度的让出点绕过去,问题就不会发作(这一步要求内核编译时启用了 PREEMPT_DYNAMIC,否则启动参数不生效)。写在最后
这类缺陷只在特定硬件和特定负载下现身,没有日志可以顺着看,也没有捷径可走,能把它挖出来,靠的是工程师愿意在没人盯着的地方把问题查到底。
这次 deepin LoongArch 内核调试,让我们看到:AI 拓展了工程师探索问题的速度与边界,而真正推动问题走向解决的,仍是对技术的敬畏、对证据的坚持和对每个细节的反复求证。当智能工具与工程经验相遇,复杂问题便有了更多被看见、被理解、被攻克的可能,每一次定位与修复,都是对系统稳定性的一次加固,也是 deepin 持续打磨底层技术、回应真实用户需求的具体实践。